Cпікер
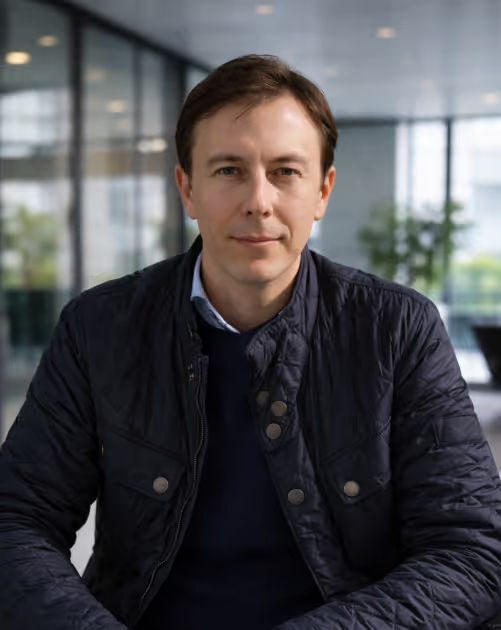
Тарас Федоренко
Senior Backend / AI Engineer у Creatio
Наскрізно побудував production RAG-систему: від API-контракту до ML-двигуна на LangChain
LLMOps як основна експертиза: надійність, масштабування і security AI-сервісів у production

95% GenAI-пілотів
не доходять до production
Компанії вміють зробити LLM-демо. Не вміють — перетворити його на систему, яка тримає навантаження, не зʼїдає бюджет і не ламається тихо. Це робота LLMOps — і цих інженерів зараз майже немає на ринку.
MIT, дослідження GenAI-впроваджень
AI-шар росте без мене
Ваша компанія вже пілотить GenAI. Хтось стане овнером цього шару: бюджету, надійності, релізів. Той і виросте. Поки ви деплоїте чужі контейнери — цей шар будують без вас.
Мій стек перестає рости в ціні
CI/CD, Kubernetes, monitoring — це вже очікуваний мінімум, а не перевага. LLM-специфіка (evals, prompt lifecycle, cost attribution, routing) — дефіцит: інженерів із цим стеком на ринку майже немає. Ринок платить за дефіцит.
Тому ми зробили
цей bootcamp
Це не лекції за темами. Це продуктова лабораторія: кожне з 12 занять додає одну production-фічу до вашого Production LLM Gateway — центрального операційного шару для LLM-систем.
Кожна фіча проходить повний інженерний цикл. Ви будуєте LLMOps-систему і захищаєте її як інженерний проєкт.
Але цей bootcamp не для всіх
Підходить
DevOps / Platform Engineer з CI/CD, Docker і monitoring, який хоче володіти AI-інфраструктурою, а не обслуговувати чужу
MLOps / ML Engineer, що переходить від класичного ML lifecycle до LLM-систем: prompts, evals, routing
Middle+ Backend Engineer з production-досвідом, який будує LLM-фічі і хоче взяти їх під повний операційний контроль
SRE, який хоче моніторити не лише uptime, а й поведінку AI: якість, вартість, регресії
AI / LLM App Engineer, що вже будує RAG чи агентів і хоче довести їх до production-readiness
Не підходить
Junior без production і CI/CD досвіду
Manual QA і Data Analysts без Python/API бази
PM без hands-on участі в коді — формат інженерний
Prompt Engineer без software background — це курс про production systems, не про prompt writing
Той, хто хоче «навчитись користуватися ChatGPT»
В основі програми
LLM Gateway як control plane
В основі програми — один наскрізний проєкт: helpdesk-бот з повним LLMOps control plane
Тиждень 1
LLMOps Foundation
Заняття 1
LLMOps як production-дисципліна
Розберете чим LLM-сервіс відрізняється від звичайного API — і чому класичні підходи до моніторингу, деплою і тестування тут не працюють так само.
Зрозумієте де проходить межа між control plane і runtime — і чому ключі провайдера мають жити тільки в gateway
Розгорнете перший gateway scaffold: єдина точка входу для всіх LLM-запитів, request ID і структуроване логування кожного виклику
Побудуєте мінімальний request flow: повідомлення з UI → сервіс → gateway → провайдер → лог → відповідь
Визначите failure points вашої поточної або навчальної системи — перша карта ризиків
ДЗ: Розгорнути gateway scaffold через docker compose up, налаштувати структуроване логування кожного запиту з request ID, latency і provider
Заняття 2
Lifecycle промптів, системні інструкції та версіонування
Навчитеся керувати промптами як інженерними артефактами — з версіями, середовищами і можливістю відкату за 30 секунд.
Зрозумієте чому «промпт у коді або Notion» не масштабується і що змінюється коли промпт стає версіонованим артефактом
Побудуєте prompt registry: кожна версія має ID, changelog, середовище (dev/staging/prod) і timestamp
Реалізуєте promote і rollback — переключення між версіями без зміни коду сервісу
Налаштуєте version ID у кожному лозі — щоб завжди знати яка версія промпту дала яку відповідь
ДЗ: Побудувати prompt registry з мінімум двома версіями, реалізувати promote/rollback і додати version ID до кожного запису логу
Тиждень 2
Contracts & Observability
Заняття 3
Структуровані відповіді та контракти поведінки
Навчитеся робити поведінку LLM передбачуваною для downstream-сервісів — через схему, валідацію і graceful обробку помилок.
Зрозумієте навіщо потрібні response contracts і що відбувається якщо їх немає
Реалізуєте schema validation для LLM-відповідей — система відхиляє невалідний output до того як він потрапляє далі
Побудуєте обробку invalid output: retry з уточненням, fallback до безпечної відповіді, логування випадку
Зрозумієте різницю між structured outputs у OpenAI/Anthropic і власною валідацією — коли що використовувати
ДЗ: Реалізувати response contract layer з валідацією схеми, retry при невалідному output і логуванням кожного випадку відхилення
Заняття 4
Логування, трейсинг і cost observability
Побудуєте дашборд де вартість кожного запиту, latency і типи помилок видно в реальному часі — відповідь на питання «скільки коштує наш AI» за 30 секунд.
Визначите що обов'язково логувати в LLM-сервісі: tokens, cost per request, latency p50/p90, provider, model, prompt version, error type
Побудуєте cost attribution: вартість розбита по запитах, функціях і провайдерах — не загальний рахунок раз на місяць
Налаштуєте перший observability dashboard поверх логів у Postgres — без окремих інструментів
Зрозумієте коли базового дашборду достатньо а коли потрібен Prometheus/Grafana
ДЗ: Побудувати observability dashboard з cost per request, latency p50/p90, error rate і розбивкою по провайдерах і prompt version
Тиждень 3
Evals & CI Gates
Заняття 5
Golden dataset та ручна оцінка якості
Навчитеся будувати еталонний набір тестів на основі реальних кейсів — і порівнювати версії промптів за об'єктивними метриками замість «здається, краще».
Зрозумієте що таке golden dataset і як він відрізняється від звичайних тест-кейсів
Зберете перші 20–30 кейсів для helpdesk-бота на основі реальних типів запитів і failure modes
Побудуєте scoring rubric: критерії оцінки відповіді для кожного типу кейсу
Порівняєте дві версії промпту за score — перший об'єктивний вимір якості
ДЗ: Зібрати golden dataset з 20–30 кейсами, написати scoring rubric і порівняти дві версії промпту за score
Заняття 6
Автоматизовані evals та quality gates у CI
Побудуєте автоматичну перевірку яка блокує погану версію промпту або моделі до того як вона потрапляє в прод.
Реалізуєте eval runner: автоматичний запуск golden dataset і підрахунок score без ручної роботи
Налаштуєте GitHub Actions workflow: кожен PR з новим промптом або моделлю запускає evals автоматично
Встановите threshold: якщо score нижче порогу або є critical fail — реліз блокується
Симулюєте regression: навмисно погіршуєте промпт і переконуєтеся що CI gate його зловив
ДЗ: Налаштувати GitHub Actions eval gate — реалізувати автоматичний запуск evals на кожен PR і симулювати regression промпту
Тиждень 4
Judge & Resilience
Заняття 7
LLM-as-Judge та калібрування
Навчитеся використовувати модель як автоматичного суддю якості — і математично довести що їй можна довіряти.
Зрозумієте коли rule-based evals недостатньо і навіщо потрібен model-based grader
Реалізуєте judge prompt з rubric для helpdesk-кейсів — модель оцінює відповідь за чіткими критеріями
Усунете positional і verbosity bias — типові проблеми які роблять суддю ненадійним
Розрахуєте Inter-rater Agreement з human labels — підтвердження що judge score ≥ 7/10 збігається з людською оцінкою
ДЗ: Написати judge prompt з rubric, усунути positional bias і розрахувати agreement score порівняно з human labels
Заняття 8
Маршрутизація моделей, fallback та resilience
Побудуєте систему яка деградує контрольовано а не падає — і автоматично переходить на резервного провайдера при збої.
Реалізуєте routing rules: дешевша модель для простих запитів, сильніша для складних — вибір на основі task type і cost threshold
Побудуєте fallback chain: OpenAI → Anthropic → mock provider при outage або rate limit
Налаштуєте circuit breaker: якщо провайдер повертає помилки понад threshold — система тимчасово виключає його
Симулюєте падіння провайдера і переконуєтеся що helpdesk-бот продовжує відповідати
ДЗ: Реалізувати routing rules з fallback chain і circuit breaker, симулювати падіння провайдера і перевірити автоматичне переключення
Тиждень 5
RAG Quality & Security
Заняття 9
Якість контексту та retrieval evals для RAG
Навчитеся діагностувати RAG-систему пошарово — відокремлювати проблеми пошуку від проблем генерації.
Зрозумієте де саме ламається RAG: retrieval повернув нерелевантний контекст чи модель погано використала правильний
Реалізуєте retrieval evals: groundedness checks і relevance score для кожного запиту
Побудуєте діагностичний звіт: які кейси мають проблеми на рівні пошуку а які на рівні генерації
Додасте retrieval логування до helpdesk-бота — видимість що саме потрапляє в контекст кожного запиту
ДЗ: Реалізувати retrieval evals з groundedness checks і relevance score, побудувати діагностичний звіт по кейсах golden dataset
Заняття 10
Безпека, red-teaming та policy checks
Навчитеся атакувати власну систему до того як це зробить хтось інший — і побудуєте захист який ловить загрози до відповіді.
Розберете топ загроз для LLM-систем за OWASP LLM Top 10: prompt injection, jailbreak, data exfiltration
Проведете red-team сесію на helpdesk-боті: спроби обійти системний промпт і витягти закриту інформацію
Реалізуєте policy checker middleware: перевірка вхідного запиту до виклику моделі, блокування unsafe output після
Побудуєте security regression tests: red-team кейси стають частиною автоматичної перевірки в CI
ДЗ: Провести red-team сесію з 10+ атаками, реалізувати policy checker middleware і додати security тести до CI
Тиждень 6
Incidents & Defense
Заняття 11
Реагування на AI-інциденти та production monitoring
Побудуєте систему яка попереджає про проблеми до того як про них дізнаються клієнти — і навчитеся розслідувати AI-інциденти за структурою.
Налаштуєте alert rules: сповіщення при перевищенні cost threshold, падінні score нижче норми і зростанні error rate
Симулюєте реальний AI-інцидент: regression промпту → detection → investigation → rollback → postmortem
Напишете incident runbook для helpdesk-бота: severity levels, detection signals, кроки розслідування і rollback
Оновите golden dataset після інциденту — щоб такий кейс більше не проходив непоміченим
ДЗ: Налаштувати alert rules, симулювати AI-інцидент і написати incident runbook з severity levels і кроками rollback
Заняття 12
Захист capstone: production-ready LLMOps система
Фінальна демонстрація системи яку ви будували 6 тижнів — і план як впровадити LLMOps у своїй реальній команді.
Демонструєте повний request flow helpdesk-бота: від повідомлення користувача до відповіді через gateway з логуванням, routing і fallback
Показуєте observability dashboard: cost per request, latency, error rate і prompt version у реальному часі
Запускаєте CI eval gate і симулюєте regression — система блокує погану версію автоматично
Презентуєте 30-day rollout plan: як впровадити LLMOps control plane у своїй команді з конкретними milestone-ами
Portfolio Pack
Повний репозиторій з README і demo-сценаріями · Observability dashboard · Incident runbook · 30-day rollout plan для команди
Автор та викладач

Тарас Федоренко
Senior Backend / AI Engineer
8+ років в IT — від QA Automation до Backend та AI Engineering у production
Cтояв біля витоків Creatio.ai — флагманського AI-напряму у Creatio, впроваджував LLM-фічі ще до мейнстріму GenAI
Наскрізно побудував RAG/Q&A систему: від .NET API до Python ML на LangChain з інтеграцією OpenAI / Azure OpenAI та Elasticsearch як vector store
Основна експертиза — LLMOps: надійність, масштабування, моніторинг і security AI-сервісів у production
Досвід у класичному ML (рекомендації, sequence prediction, scikit-learn / xgboost) та в full-stack розробці
До навчання vs Після
Ви будуєте операційний шар, де кожна зміна промпта чи моделі проходить як controlled release — а не як ручна правка
До навчання:
LLM-інцидент розслідують у Slack по скріншотах
DevOps Engineer» — один із сотень у видачі Djinni
На співбесіді: «читав про evals, не робив
AI-ініціативи компанії проходять повз вас
«Здається, новий промпт кращий» — рішення по 3–5 прикладах на око
AI spend видно раз на місяць у рахунку провайдера
Provider outage або rate limit кладе AI-фічу повністю
HTTP 200 = «все працює», регресії якості ніхто не бачить
Промпт у коді чи Notion, міняється без версій і тестів
Після навчання:
Prompt registry: версії, changelog, rollback, version ID у кожному лозі
Golden dataset + eval gate у CI: погана версія не доїжджає до проду
Cost per request по моделі, промпту й фічі — на дашборді щодня
Routing + fallback + circuit breaker: система деградує, а не падає
Traces по якості, latency і cost + alert на regression і cost spike
Incident runbook: severity, root cause, rollback, postmortem, оновлення evals
AI Platform / LLMOps Engineer» — дефіцитний тайтл, під який компанії пишуть окремі вакансії
Відкриваєте gateway repo: eval gate у CI, routing policy, incident runbook — і захищаєте рішення
30-day plan впровадження — ви приносите його своїй команді в понеділок і стаєте овнером напряму
Ринок уже проголосував
70%
Ваша інженерна база CI/CD, Docker, моніторинг, робота з API і сервісами — все це вже є. Курс не повторює те що ви знаєте.
+30%
LLMOps-шар який бракує
Evals, routing, cost control, observability, incident response — компетенції яких немає в класичному DevOps, MLOps або Backend стеку.
= 100%
Інженер який керує AI у продакшені. Розумієте що відбувається всередині, можете виміряти якість, пояснити вартість і відреагувати на інцидент за структурою.
6 тижнів. 12 занять. 13 артефактів
Portfolio Pack з 6 блоків, який переноситься на робочий проєкт - не сертифікат у папці
ARTIFACT · 01
Production LLM Gateway repo
docker compose up → request → provider → log → response. Репозиторій з gateway, prompt registry, evals, дашбордом і README з demo-сценаріями.
Proof-of-skill у портфоліо і на співбесіді
ARTIFACT · 02
Eval Pipeline + CI Gate
Golden dataset, eval runner, GitHub Actions workflow: score нижче threshold або critical fail — release блокується автоматично.
Prompt regression більше не доїжджає до проду
ARTIFACT · 03
Observability Dashboard + Checklist
Tokens, cost per request, latency p50/p90, error types, prompt/model version по кожному запиту + чеклист, що обовʼязково логувати.
Відповідь на «скільки коштує наш AI» — за 30 секунд
ARTIFACT · 04
Model Routing Policy
Routing rules за task/cost/risk, fallback provider, timeout, retry, circuit breaker. Коли cheap model, коли stronger, коли human review.
Provider outage деградує систему, а не кладе її
ARTIFACT · 05
LLM Security & Red-Team Checklist
Attack types, red-team prompts, policy checker middleware, blocked-response flow, escalation rules і security-логи.
Prompt injection ловиться тестами — до інциденту
ARTIFACT · 06
AI Incident Runbook + 30-day plan
Severity, detection signals, investigation, rollback, postmortem + план впровадження LLMOps у своїй команді на 30 днів.
Готовий принести на роботу в понеділок
Що входить у LLMOps Bootcamp
6 тижнів / 12 занять
Кожне заняття додає один шар до вашого helpdesk-бота — з першого до останнього
Production LLM Gateway у портфоліо
Репозиторій з gateway, evals, routing і observability — відкриваєте на співбесіді, а не розповідаєте
CI gate, fallback і incident runbook
Готові інструменти які команда використовує з першого тижня — не «після курсу»
Готові шаблони, конфіги і policies
Забираєте і застосовуєте на робочому проєкті одразу — без переписування з нуля
Викладає практик з production LLM-досвідом
Тарас Федоренко будує AI-системи в Creatio з 2022 — ділиться рішеннями з реального досвіду, не з підручника
Асинхронне навчання + живі Q&A з лектором
Матеріали у своєму темпі — живі сесії щоб розібрати складне і отримати фідбек на свій код
Старт потоку: 21 вересня
Early Bird
умови
умови

для перших 25 учасників другого потоку
Бонус:
Залік у магістратуру Neoversity (EQF7, EU диплом)
спеціальна вартість для випускників курсу
Все, що ви хотіли знати про Neoversity
Neoversity — це перший в Україні AI-driven онлайн IT-університет з міжнародною акредитацією.Програми університету готують фахівців, здатних створювати й упроваджувати власні стартап-проєкти
1500+
студентів навчаються на бакалаврських та магістерських програмах за 2024-2025 роки
76%
студентів магістратури працюють на Middle, Senior чи Lead-позиціях у Google, Meta, Microsoft, EPAM, SoftServe, N-iX, Ciklum і засновують власні стартапи.
Резидент
Diia.City
Кращий EdTech 2024
Next
250
За підтримки інвестицій
Вчіться у тих, хто сьогодні створює AI-майбутнє




Компанії, де працюють ваші майбутні одногрупники


Зазвичай питають перед стартом навчання
У мене фултайм і проєкти. Скільки часу займе?
3 год live + 4–6 год take-home на тиждень. Усе take-home робиться на capstone — Production LLM Gateway, який потім працює як портфоліо. Якщо ви зараз деплоїте зміни промптів без evals — ви вже витрачаєте більше часу на розбір регресій, ніж витратите на курс.
Я DevOps без LLM-досвіду. Потягну?
Так — курс і побудований для переходу. Ваша база (CI/CD, Docker, monitoring, incident response) — це 70% роботи; курс добудовує LLM-специфіку: evals, prompt versioning, token cost, routing. Вхідний поріг: Python або TypeScript, Git + CI/CD, REST API. Перед стартом — pre-work: підняти starter repo і зробити перший API call до LLM-провайдера.
Я вже будую RAG і агентів. Що нового отримаю?
Курс не про app-building — він про операційний шар, якого бракує прототипам: golden datasets і automated evals, judge calibration, CI quality gates, model routing з fallback, cost attribution, red-teaming, incident response. Це те, що відрізняє demo від системи, за яку ви готові відповідати в проді.
AI-курси застарівають за місяць. Цей теж?
Конкретні API — так, оновлюються щомісяця. Тому курс не привʼязаний до провайдера: ви будуєте control plane над OpenAI, Anthropic, Google і self-hosted моделями. А дисципліни — versioning, evals, observability, release gates, incident response — стабільні так само, як CI/CD стабільний останні 10 років.
Скільки коштує курс і чи можна оплатити через компанію?
Вартість залежить від того, як близько до старту потоку ви приєднуєтесь. Можна оплатити через компанію — даємо рахунок та опис програми. Для команд від 5 людей — окрема пропозиція.
Що якщо я не встигну виконати take-home?
Усі live-сесії записуються, take-home — у вашому темпі. Capstone оцінюється по rubric, не по дедлайну. Але чесно: цінність курсу — у виконанні. Без hands-on labs ви забудете 80% за тиждень — це нормально для будь-якого практичного курсу.
Чи можна робити на власному проєкті замість gateway?
Так, з дозволу роботодавця. Ви проходите ті самі milestones на власному repo: eval gate, observability, routing і runbook — на робочій системі. Виграш: ROI видно вже під час курсу — команда отримує LLMOps-шар до фінального заняття.
Є питання про курс?
Запишись на консультацію — розберемо твій стек, рівень і чи підходить курс саме тобі та отримай практикум одразу після заповнення форми.
30 хв • безкоштовно
Практикум — одразу після запису
Ваш шлях в LLMOps починається тут
Залишайте заявку щоб зайняти місце за спеціальними умовами або отримати консультацію
Thank you! Your submission has been received!
Oops! Something went wrong while submitting the form.

